数据库的约束类型主要包括以下几种:
这些约束保证了数据库中的数据完整性和一致性,是设计数据库时的重要组成部分。
主键约束(Primary Key Constraint)
主键约束用于唯一标识表中的每一行,并确保其值不为NULL。
CREATE TABLE Students (
    StudentID INT PRIMARY KEY,
    StudentName VARCHAR(20)
);
对于整数类型的主键,常配搭自增长auto_increment来使用。插入数据对应字段不给值时,使用最大值+1。
StudentID INT PRIMARY KEY auto_increment,
外键约束(Foreign Key Constraint)
外键约束用于维护不同表之间的关系,确保引用的数据存在。
CREATE TABLE Courses (
    CourseID INT PRIMARY KEY,
    CourseName VARCHAR(100)
);
CREATE TABLE Enrollments (
    EnrollmentID INT PRIMARY KEY,
    StudentID INT,
    CourseID INT,
    FOREIGN KEY (StudentID) REFERENCES Students(StudentID),
    FOREIGN KEY (CourseID) REFERENCES Courses(CourseID)
);
唯一约束(Unique Constraint)
唯一约束确保字段值的唯一性,不能重复,但允许NULL值。
CREATE TABLE Users (
    UserID INT PRIMARY KEY,
    Email VARCHAR(100) UNIQUE
);
检查约束(Check Constraint)
检查约束用于确保字段值满足特定条件。
CREATE TABLE Products (
    ProductID INT PRIMARY KEY,
    Price DECIMAL(null, 2) CHECK (Price >= 0)
);
非空约束(NOT NULL Constraint)
非空约束确保某一列的值不能为空。
CREATE TABLE Employees (
    EmployeeID INT PRIMARY KEY,
    EmployeeName VARCHAR(100) NOT NULL
);
默认约束(Default Constraint)
默认值约束在插入新记录时指定列的默认值。
CREATE TABLE Orders (
    OrderID INT PRIMARY KEY,
    OrderDate DATETIME DEFAULT CURRENT_TIMESTAMP
);
这些约束在创建和管理数据库表时非常重要,有助于维护数据的完整性和准确性。
常见的统计总数、计算平局值等操作,可以使用聚合函数来实现,常见的聚合函数有:
这些聚合函数用于对一组数据进行汇总和分析,是数据库查询的重要工具。
COUNT()COUNT() 函数用于计算表中的行数或特定列中非NULL值的数量。
用法:
SELECT COUNT(*) FROM 表名;
SELECT COUNT(列名) FROM 表名
示例:
SELECT COUNT(*) FROM Employees;  -- 计算员工总数
SELECT COUNT(EmployeeID) FROM Employees;  -- 计算非NULL的员工ID数量
SUM()SUM() 函数用于计算数值型列的总和。
用法:SELECT SUM(列名) FROM 表名;
示例:
SELECT SUM(Salary) FROM Employees; -- 计算所有员工的工资总和
AVG()AVG() 函数用于计算数值型列的平均值。
用法:SELECT AVG(列名) FROM 表名;
示例:
SELECT AVG(Salary) FROM Employees; -- 计算所有员工的平均工资
MAX()MAX() 函数用于返回指定列中的最大值。
用法:SELECT MAX(列名) FROM 表名;
示例:
SELECT MAX(Salary) FROM Employees; -- 找到最高的工资
MIN()MIN() 函数用于返回指定列中的最小值。
用法:SELECT MIN(列名) FROM 表名;
示例:
SELECT MIN(Salary) FROM Employees; -- 找到最低的工资
这些聚合函数可以单独使用,也可以与 GROUP BY 子句结合使用,以对结果进行分组和汇总分析。
SELECT 中使用 GROUP BY 子句可以对指定列进行分组查询。需要满足:使用 GROUP BY 进行分组查询时,SELECT 指定的字段必须是“分组依据字段”,其他字段若想出现在SELECT 中则必须包含在聚合函数中。
select column1, sum(column2), .. from table group by column1,column3;
GROUP BY 子句进行分组以后,需要对分组结果再进行条件过滤时,不能使用 WHERE 语句,而需要用HAVING。
使用案例
下面是一个结合聚合函数、GROUP BY 和 HAVING 的使用案例。
假设我们有一个名为 Sales 的表,其中包含以下字段:
SalesID:销售记录的唯一标识SalesAmount:销售金额SalesPerson:销售人员的名称SalesDate:销售日期我们想要查询每个销售人员的总销售金额和平均销售金额,并且只返回那些总销售金额超过 10,000 的销售人员。
以下是相应的 SQL 查询示例:
SELECT
    SalesPerson,
    SUM(SalesAmount) AS TotalSales,
    AVG(SalesAmount) AS AverageSales
FROM
    Sales
GROUP BY
    SalesPerson
HAVING
    SUM(SalesAmount) > 10000;
在这个查询中:
GROUP BY SalesPerson 将结果按销售人员进行分组。SUM(SalesAmount) 计算每个销售人员的总销售金额。AVG(SalesAmount) 计算每个销售人员的平均销售金额。HAVING SUM(SalesAmount) > 10000 筛选出总销售金额超过 10,000 的销售人员。这个案例展示了如何结合聚合函数和 GROUP BY 与 HAVING 条件来分析数据。
实际开发中往往数据来自不同的表,所以需要多表联合查询。多表查询是对多张表的数据取笛卡尔积:
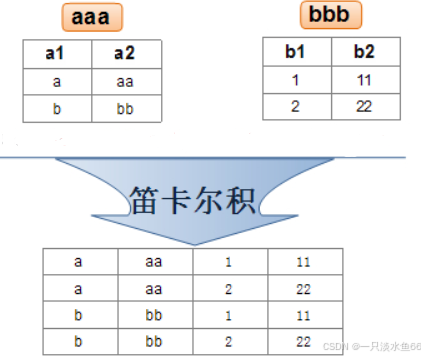
注意:关联查询可以对关联表使用别名。
select 字段 from 表1 别名1 [inner] join 表2 别名2 on 连接条件 and 其他条件;
select 字段 from 表1 别名1,表2 别名2 where 连接条件 and 其他条件;
外连接分为左外连接和右外连接。如果联合查询,左侧的表完全显示我们就说是左外连接;右侧的表完全显示我们就说是右外连接。
-- 左外连接,表1完全显示
select 字段名 from 表名1 left join 表名2 on 连接条件;
-- 右外连接,表2完全显示
select 字段 from 表名1 right join 表名2 on 连接条件;
自连接是指在同一张表连接自身进行查询。
select 字段名 from 表1 as 别名 ,表1 as 别名 where 连接条件 and 其他条件;
下面是一个关于数据库中联合查询(也称为联接查询)的案例,结合多个表进行数据检索。
假设我们有两个表:
Customers 表
CustomerID:客户唯一标识CustomerName:客户姓名ContactNumber:联系方式Orders 表
OrderID:订单唯一标识OrderDate:订单日期CustomerID:关联的客户ID(外键)TotalAmount:订单总金额我们希望查询每个客户的订单信息,包括客户姓名和订单总金额。
以下是结合 INNER JOIN 的 SQL 查询示例:
SELECT
    Customers.CustomerName,
    Orders.TotalAmount
FROM
    Customers
INNER JOIN
    Orders ON Customers.CustomerID = Orders.CustomerID;
在这个查询中:
INNER JOIN 用于将 Customers 表和 Orders 表连接起来。ON Customers.CustomerID = Orders.CustomerID,即通过客户ID来匹配订单和客户信息。Customers.CustomerName 和 Orders.TotalAmount 来显示客户姓名和相应的订单总金额。这个案例展示了如何在数据库中使用联合查询来获取来自多个表的相关数据。
子查询是指嵌入在其他sql语句中的select语句,也叫嵌套查询
1、单行子查询:返回一行记录的子查询
2、多行子查询:返回多行记录的子查询
下面是一个关于数据库中子查询的案例,展示如何使用子查询来获取相关数据。
假设我们有两个表:
Employees 表
EmployeeID:员工唯一标识EmployeeName:员工姓名DepartmentID:员工所在部门的IDSalary:员工工资Departments 表
DepartmentID:部门唯一标识DepartmentName:部门名称现在,我们想要查询那些工资高于该部门平均工资的员工姓名和工资。我们可以通过子查询来实现这个目标。
以下是相应的 SQL 查询示例:
SELECT
    EmployeeName,
    Salary
FROM
    Employees
WHERE
    Salary > (
        SELECT
            AVG(Salary)
        FROM
            Employees
        WHERE
            DepartmentID = Employees.DepartmentID
    );
在这个查询中:
Employees 表中选择 EmployeeName 和 Salary。(SELECT AVG(Salary) FROM Employees WHERE DepartmentID = Employees.DepartmentID) 计算每个部门的平均工资。WHERE 子句中,条件 Salary > (子查询) 用于过滤出工资高于该部门平均工资的员工。这个案例展示了如何在数据库中使用子查询来进一步筛选和获取数据。
在实际应用中,为了合并多个select的执行结果,可以使用集合操作符 union,union all。使用UNION和UNION ALL时,前后查询的结果集中,字段需要一致。
union
该操作符用于取得两个结果集的并集。当使用该操作符时,会自动去掉结果集中的重复行。
union all
该操作符用于取得两个结果集的并集。当使用该操作符时,不会去掉结果集中的重复行。
合并查询通常是指使用 UNION 运算符将多个 SELECT 查询的结果合并在一起。下面是一个关于数据库中合并查询的案例。
假设我们有两个表:
Customers 表
CustomerID:客户唯一标识CustomerName:客户姓名ContactNumber:联系方式Suppliers 表
SupplierID:供应商唯一标识SupplierName:供应商姓名ContactNumber:联系方式我们希望从这两个表中获取所有联系人姓名,无论是客户还是供应商。可以使用 UNION 查询来合并两个表中的联系人的姓名。
以下是相应的 SQL 查询示例:
SELECT
    CustomerName AS ContactName
FROM
    Customers
UNION
SELECT
    SupplierName AS ContactName
FROM
    Suppliers;
在这个查询中:
SELECT 查询从 Customers 表中选取 CustomerName,并将其重命名为 ContactName。SELECT 查询从 Suppliers 表中选取 SupplierName,同样将其重命名为 ContactName。UNION 将两个查询的结果合并在一起,自动去除重复的值。请注意,使用 UNION 时,两个查询的列数和数据类型必须相匹配。
这个案例展示了如何在数据库中使用合并查询来获取来自多个表的相关数据。
到此这篇关于MySQL 数据库约束、聚合查询和联合查询的文章就介绍到这了,更多相关mysql聚合查询和联合查询内容请搜索插件窝以前的文章或继续浏览下面的相关文章希望大家以后多多支持插件窝!
